Зачем вообще конвейер: короткая исповедь
Начну с провала, потому что этот конвейер вырос из него. На прошлой версии блога вышло 234 статьи — их писал конвейер старого образца: брал новости из RSS-лент чужих блогов, переписывал под наш язык, публиковал. По 8–59 статей в месяц.
Результат: в поиске Яндекса закрепилось около 20 страниц. Остальные получили метку «малоценная или маловостребованная» и вылетели из индекса. Раздел запросов в Вебмастере — пустой. Ноль.
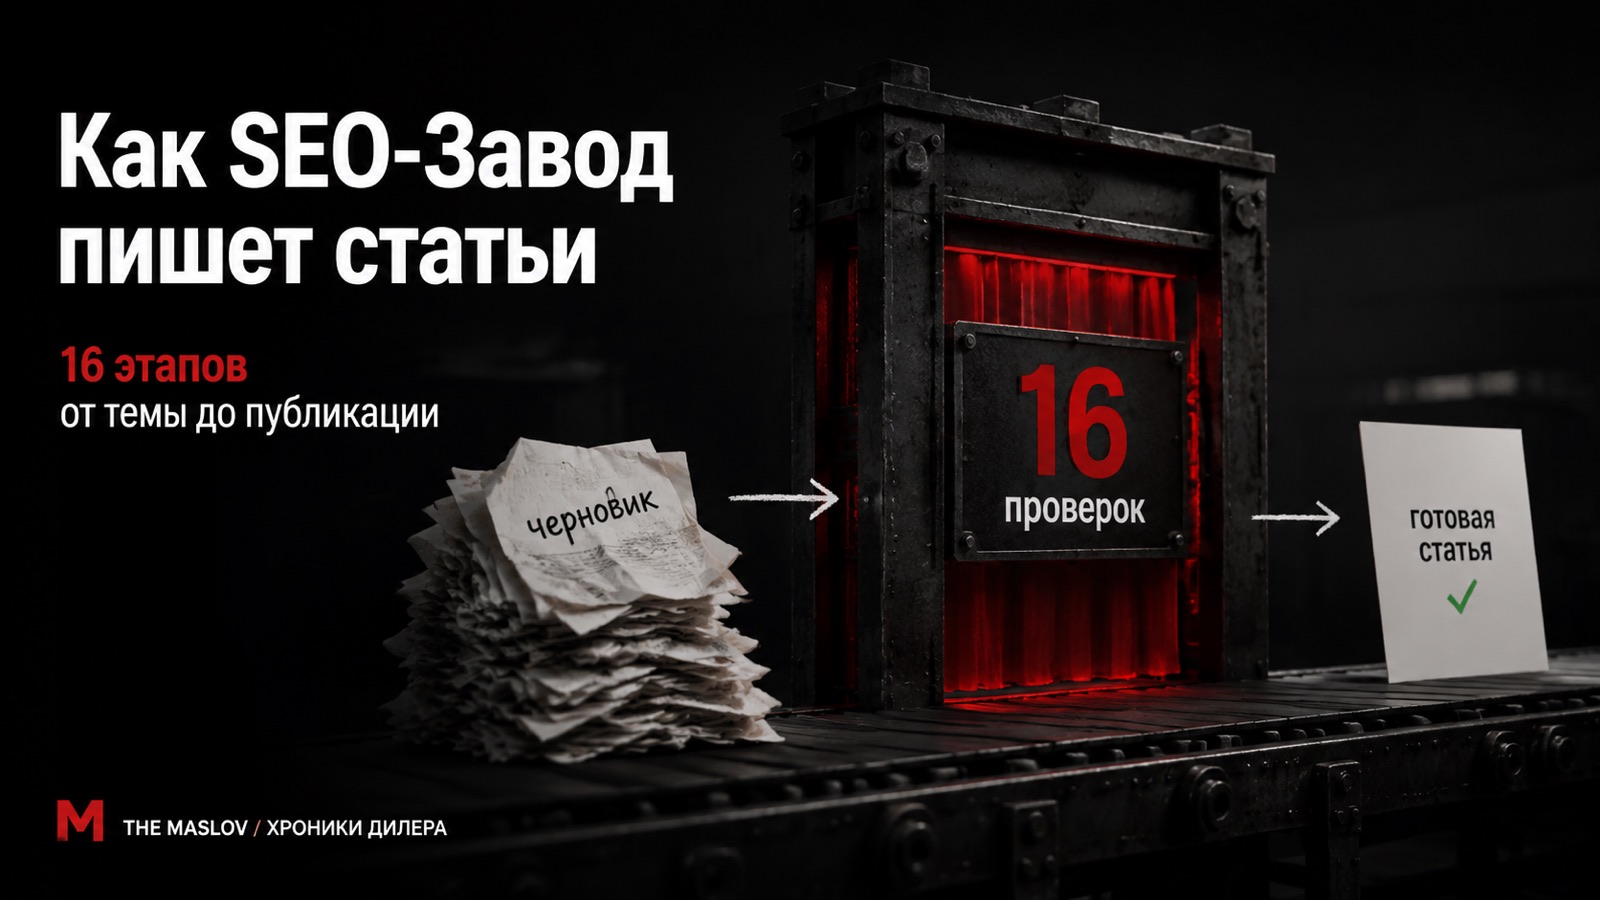
Вывод был простой: дело не в количестве и даже не в качестве текста самого по себе. Дело в том, что писать и есть ли на это спрос. Так появился конвейер нового образца — 16 этапов, четыре фазы: поиск, выбор, написание, валидация.
Фаза 1. Тема рождается из спроса, а не из вдохновения
Система собирает пул минимум из 20 тем-кандидатов из трёх независимых источников — и все три работают как датчики спроса.
Вирусность за 14 дней
Три агента-разведчика идут по Reddit, Hacker News, LinkedIn, X и YouTube. Критерий — не «тему упоминают», а «тема выстрелила»: тред на тысячу апвотов, пост лидера мнений с тысячами лайков. Виральность — доказательство, что аудитория голодная прямо сейчас. Окно жёсткое: старше двух недель — не тренд.Дыры в выдаче
Четвёртый агент проверяет: а что по этой теме есть на русском? Поисковые подсказки показывают реальные запросы живых людей, разбор топ-10 — качество конкурентов. Золотая жила: в мире тема горит, подсказки есть, а качественного материала на русском нет.Свой бэклог
Собственные наработки, боли аудитории из комментариев и переписок, очередь отложенных тем. Каждая проходит те же фильтры, что и внешние кандидаты, — никакого «раз тема есть, пишем».
Разница со старым конвейером — в одну строку. Раньше внешние источники были сырьём для рерайта. Теперь они — датчик спроса, а текст всегда пишется с нуля.
Фаза 2. 9 осей, 220 баллов и право сказать «нет»
Каждая тема-кандидат получает оценку по девяти осям. Самые тяжёлые — с тройным весом:
| Ось | Что проверяет |
|---|---|
| Вирусность за 14 дней | Сколько источников подтвердили тему и какая вовлечённость |
| Свежесть | Тема на пике сейчас или уже остыла |
| Дыра в выдаче | Есть ли на русском качественный ответ |
| Свой материал | Есть ли у нас опыт и фактура, которых нет ни у кого |
| Близость к делу | Ведёт ли тема к тому, чем мы реально занимаемся |
Дальше — спрос, соответствие аудитории, широта охвата и сложность исполнения. Максимум — 220 баллов.
И вот главное отличие от вала: порог. Лучший кандидат не добрал до порога — система не пишет вообще. Так и говорит: сильной темы нет, беру в бэклог, жду новых сигналов. Старый конвейер писал всегда, потому что мерил себя количеством. Этот умеет молчать.
Есть и защита от залипания в одной теме: если три статьи подряд вышли про один угол, система принудительно занижает ему баллы и вытаскивает смежные темы. Это лечит болезнь, которой переболел прошлый блог: сотни статей в одну и ту же полку, а по соседним запросам — пусто.
Фаза 3. Research вместо пересказа
Когда тема выбрана, текст не пишется «из головы нейросети». Сначала работают исследователи.
Один агент копает внешние источники: официальная документация и первоисточники в приоритете, минимум восемь разных доменов, SEO-помойки исключены явным запретом. Отдельно собираются боли новичков с форумов — реальные вопросы реальных людей, на которые в выдаче никто не ответил. И цитаты с атрибуцией: дословный текст, автор, ссылка.
Второй агент идёт по внутренним материалам: наши разборы, наши формулировки, наш опыт. Это то, чего нет у конкурентов, — и то, что превращает статью из пересказа в источник.
Структура собирается из болей: каждый раздел закрывает один реальный вопрос из research. Раздел, за которым не стоит чья-то боль, — вода, его режут на взлёте.
Фаза 4. Шесть проверяющих, которых нельзя уговорить
Готовый черновик уходит на валидацию к шести независимым агентам, каждый со своим узким мандатом:
- Факт-чекер — ни одной цифры и цитаты без верифицированного источника. Без его зелёного вердикта статья не выходит.
- Детектор ИИ-штампов — три слоя проверки, от невидимых юникод-маркеров до канцелярита и монотонного ритма.
- Стоп-словарь — запрещённые обороты, юридические риски, обещания гарантированного результата.
- Тон и голос — статья должна звучать как автор, а не как «контент».
- SEO-структура — заголовки, мета-поля, разметка, внутренние ссылки.
- Перелинковка — статья встраивается в существующий кластер, а не висит в вакууме.
Поверх всего — физический чек-лист на 50 с лишним пунктов, где галочка ставится только при наличии артефакта-доказательства. «Вроде бы сделал» не принимается: либо есть отчёт проверки, либо пункт открыт и публикации нет.
Что это даёт — и чего не даёт
Честно: конвейер не делает чудес за неделю. SEO — игра вдолгую, системный трафик копится месяцами. Быстрыми бывают только дыры в выдаче — там, где конкурентов нет, страница может встать в топ почти сразу.
Что конвейер даёт гарантированно — так это отсутствие пустых выстрелов. Каждая статья либо имеет обоснованный шанс (спрос проверен, конкуренция посчитана, своя фактура есть), либо не пишется. После 234 статей в никуда я считаю это главной функцией системы.
Частые вопросы
- Это всё пишет нейросеть?
- Пишет система из агентов под управлением методологии, а решения по темам и финальный вердикт — за человеком. Каждый факт проходит проверку источника, каждый текст — шесть контролей качества.
- Почему просто не писать больше статей?
- Пробовали: 234 штуки. Поисковику не нужно «больше» — ему нужен лучший ответ на конкретный запрос. Одна статья под проверенный спрос работает лучше пятидесяти в пустоту.
- Что будет со старыми статьями?
- Они стали сырьём: 685 тем из архива прошли в очередь кандидатов и будут проверены на спрос наравне с новыми. Лучшие переродятся нормальными статьями, остальные останутся в бэклоге.